Que chaque watt
produise une intelligence digne de confiance

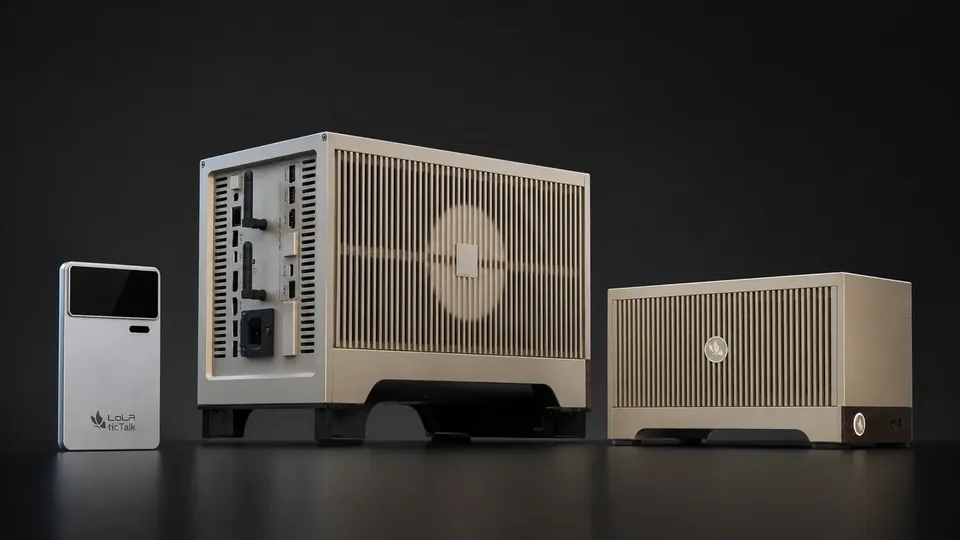
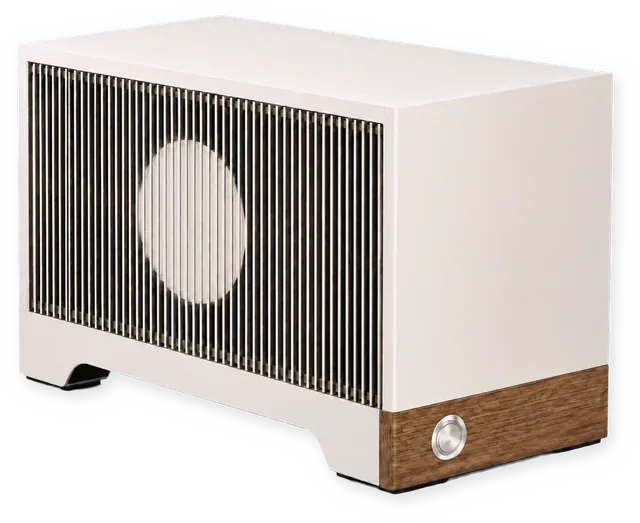
Le socle de confiance est d’abord physique : les données restent sur le terminal, l’inférence s’exécute localement et le calcul appartient à l’entreprise. LoLR.AI développe donc ses propres appareils de calcul local. Pour optimiser le calcul dans un volume et une puissance limités, des FPGA — circuits programmables adaptés à des tâches spécifiques — et des puces d’accélération dédiées complètent le calcul généraliste. La charge est répartie par type de tâche, puis le réseau de calcul distribué LoLR orchestre terminaux, périphérie et cloud dans un ensemble planifiable et auditable.

  • CPULogique et orchestration : décisions logiques complexes, orchestration système et petites tâches non structurées.
  • GPUInférence parallèle : inférence des grands modèles et calcul matriciel parallèle, au cœur du calcul IA.
  • FPGA · Accélération dédiéeAccélération en pipeline de tâches fréquentes : gestion de la mémoire, OCR et chiffrement, pour une nette réduction de la consommation.
  • Orchestration coordonnéeRépartition des charges par tâche ; tous les appareils utilisent le même système LoLR.AI OS et les mêmes Skills.
Découvrir tous les appareils LoLR HPCs→
CPU
Logique et orchestrationApplication des règles · Orchestration système · Petites tâches non structurées
GPU
Accélération de l’inférence parallèleInférence des grands modèles · Calcul matriciel parallèle · Calcul IA central
FPGA
Accélération matérielle dédiéeFPGA et puces d’accélération dédiées · Gestion de la mémoire · OCR · Chiffrement
Calcul généraliste pour les tâches fréquentes
1×
Accélération matérielle dédiée
10×

Comparaison de l’efficacité énergétique sur des tâches fréquentes spécifiques — gestion de la mémoire, OCR, chiffrement — en laboratoire. Les performances globales dépendent des modèles et de l’environnement d’utilisation.

Organisation du calcul entre terminaux et cloud

La puissance d’un appareil est limitée, mais les tâches d’une entreprise se répartissent entre individus, services et organisations. Le réseau de calcul distribué LoLR relie appareils portables, postes de bureau, serveurs intranet et cloud autorisé : répartition hétérogène au sein des nœuds, orchestration unifiée du réseau et échanges maîtrisés par des liaisons sécurisées.

Orchestration unifiée · LoLR.AI OS Le lieu d’exécution de chaque tâche dépend de la sensibilité des données, de la latence, de la taille du modèle et du coût Terminaux Appareils portables et personnels LoLR ticTALK · mini · BOX Traitement des tâches fréquentes au plus près OCR · Transcription · Recherche en mémoire · Questions courantes CPU · GPU · FPGA · Accélération dédiée Données sur le terminal · Réponse en millisecondes · Faible consommation Périphérie Intranet des services et organisations LoLR STUDIO · STATION LoLR STATION Solutions sur projet · Format rack Inférence des grands modèles et partage multiutilisateur Risques de conformité · Experts numériques de service · Analyse de l’ensemble des données CPU · GPU · FPGA · Accélération dédiée · Orchestration multiappareil Toutes les données restent dans le périmètre · Forte simultanéité · Technologies chinoises maîtrisées Cloud Cloud autorisé LoLR Cloud · Accès autorisé au calcul public LoLR Cloud Calcul élastique et mises à jour des modèles Analyse à grande échelle · Raisonnement interdomaines · Mises à jour des modèles et Skills Calcul GPU élastique · Appels selon les autorisations et politiques de données Uniquement les tâches autorisées · Traçabilité complète des appels Liaisons sécurisées : authentification des appareils · Chiffrement de bout en bout · Contrôle des droits · Audit complet Les données brutes restent sur leur nœud d’origine ; tâches, conclusions et capacités de modèle autorisées circulent entre les nœuds
(Faites glisser horizontalement pour voir le schéma complet)
L’orchestration unifiée choisit le niveau d’exécution — terminal, périphérie ou cloud — et les liaisons sécurisées maîtrisent les échanges entre nœudsRéseau de calcul distribué LoLR · Schéma
Nœuds de calcul hétérogènes

Chaque nœud répartit les tâches : logique et orchestration sur CPU, inférence parallèle sur GPU, tâches fréquentes de gestion de mémoire, OCR et chiffrement sur FPGA et puces dédiées.

Orchestration distribuée

Le terminal, la périphérie ou le cloud est choisi selon la sensibilité des données, la latence, la taille du modèle et le coût. Les appareils de l’organisation sont orchestrés ensemble selon la simultanéité requise.

Liaisons sécurisées

Authentification des appareils, chiffrement de bout en bout, contrôle des droits et traçabilité complète. Les données brutes restent sur leur nœud d’origine ; tâches et conclusions circulent entre nœuds.

Calcul distribué à haute efficacité énergétique

Les tâches fréquentes s’exécutent au plus près sur du matériel dédié ; l’inférence des grands modèles se concentre sur les nœuds de service ou d’organisation ; les besoins élastiques utilisent le cloud autorisé. Le calcul est alloué selon son efficacité énergétique.

Socle de confiance=Nœuds hétérogènes à haute efficacité énergétique+Réseau de calcul distribué+Liaisons sécuriséesPour une souveraineté sur les données, le calcul et les activités : l’entreprise conserve ses données, maîtrise son calcul et définit ses activités.