让每一瓦特电力
都转化为可信的智能

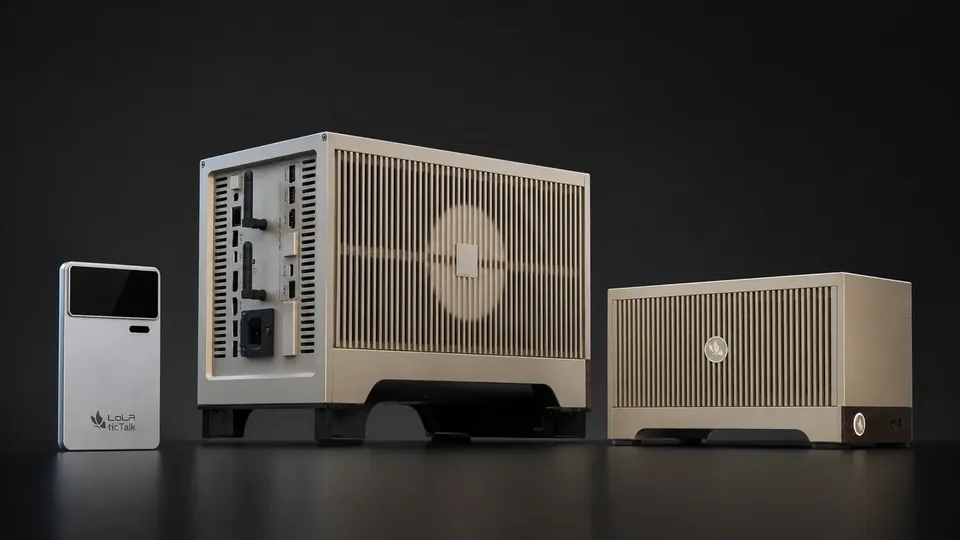
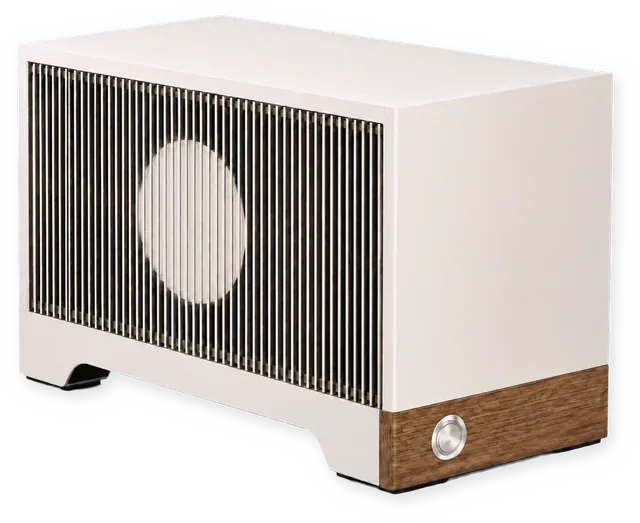
可信基座首先是物理层面的:数据不出端、推理在本地、算力归企业,因此罗格自主研发端侧算力设备。端侧功耗与体积受限,算力必须充分利用:在通用计算之上引入 FPGA(现场可编程门阵列,可为特定任务定制的专用硬件)与专用加速芯片,按任务类型分配计算负载;再由罗拉分布式算力网络将端、边、云组织为可调度、可审计的整体。

  • CPU逻辑与调度:复杂逻辑判断、系统调度及非结构化小任务。
  • GPU并行推理:大模型推理与并行矩阵运算,提供核心 AI 算力。
  • FPGA · 专用加速记忆管理、OCR 识别、安全加密等高频任务的流水线加速,显著降低功耗。
  • 协同调度按任务类型分配负载;全系设备运行同一套 LoLR.AI OS 与 Skills 体系。
了解罗拉超算全系设备→
CPU
逻辑与调度规则判断 · 系统调度 · 非结构化小任务
GPU
并行推理加速大模型推理 · 并行矩阵运算 · 核心 AI 算力
FPGA
专用硬件加速FPGA 与专用加速芯片 · 记忆管理 · OCR 识别 · 安全加密
通用计算处理高频任务
1×
专用硬件加速
10×

记忆管理、OCR、加密等特定高频任务的能效对比,实验室条件数据;整机表现取决于所运行的模型与使用环境。

端云协同的算力组织方式

单台设备算力有限,企业任务却分布在个人、部门与机构之间。罗拉分布式算力网络将随身设备、桌面设备、机构内网服务器与经授权的云端组织为一个算力网:节点内部异构分工,网络层面统一调度,安全链路保证节点间的流转受控。

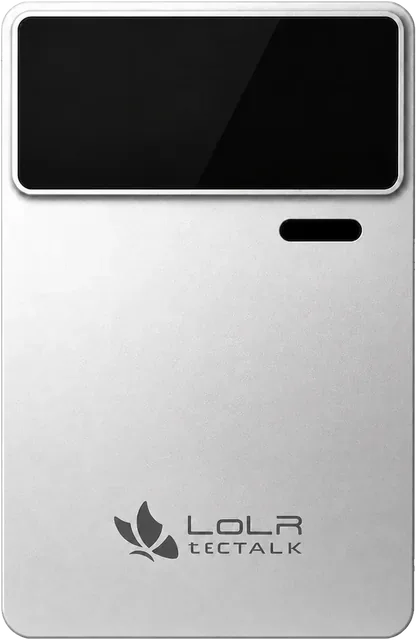
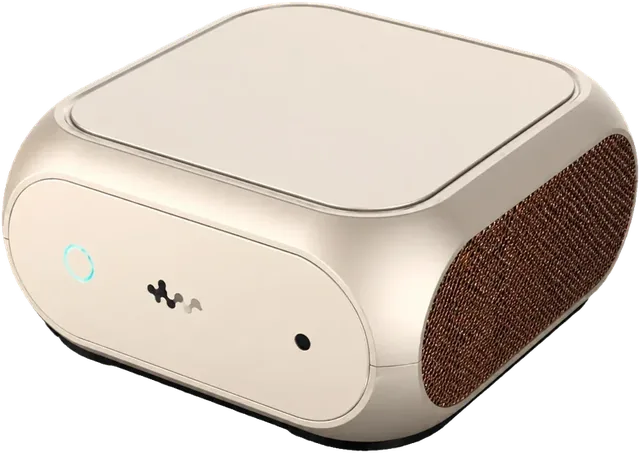
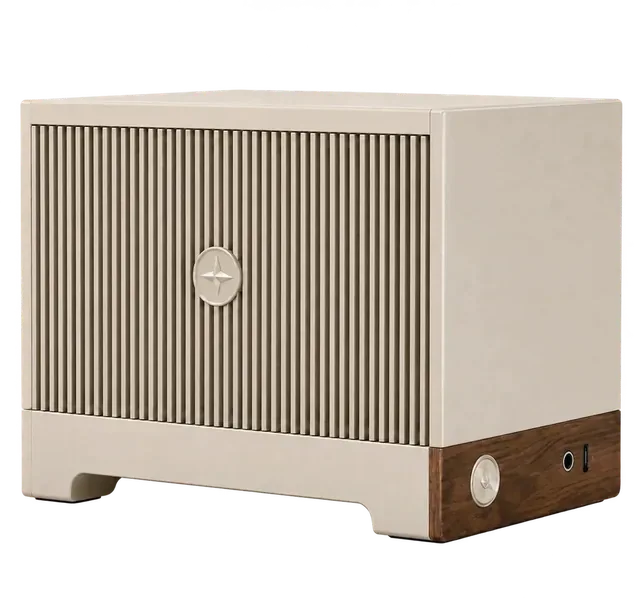
统一调度 · LoLR.AI OS 按数据敏感度 · 时延要求 · 模型规模 · 成本,决定每项任务的执行位置 端 随身与个人设备 LoLR ticTALK · mini · BOX 高频任务就近处理 OCR · 转写 · 记忆检索 · 日常问答 CPU · GPU · FPGA · 专用加速 数据不出端 · 毫秒级响应 · 低功耗 边 部门与机构内网 LoLR STUDIO · STATION LoLR STATION 项目制方案 · 机架级 大模型推理与多人共享 合规风控 · 部门级数字专家 · 全量数据分析 CPU · GPU · FPGA · 专用加速 · 多机编排 全量数据不出域 · 高并发 · 国产信创 云 经授权的云端 LoLR Cloud · 按授权接入的公共算力 LoLR Cloud 弹性算力与模型更新 大规模分析 · 跨域推理 · 模型与 Skills 更新 弹性 GPU 算力 · 按授权与数据策略调用 仅处理经授权的任务 · 调用全程留痕 安全链路:设备身份认证 · 端到端加密 · 权限控制 · 全程审计 原始数据留在产生它的节点;节点之间流转的是任务、结论与经授权的模型能力
(可左右滑动查看完整图示)
统一调度决定任务在端、边、云的哪一层执行,安全链路保证节点间流转受控罗拉分布式算力网络 · 示意
异构算力节点

节点内部按任务分工:CPU 负责逻辑与调度,GPU 负责并行推理,FPGA 与专用加速芯片负责记忆管理、OCR、加密等高频任务。

分布式调度

按数据敏感度、时延要求、模型规模与成本,决定任务在端、边、云的执行位置;组织内多台设备按并发统一编排。

安全链路

设备身份认证、端到端加密、权限控制与全程留痕;原始数据留在产生它的节点,节点间流转的是任务与结论。

高能效分布式计算

高频任务就近由端侧专用硬件完成,大模型推理集中于部门与机构级节点,弹性需求按授权使用云端;算力按能效配置。

可信基座=高能效异构节点+分布式算力网络+安全链路由此实现数据主权、算力主权与业务主权:数据由企业保有,算力由企业支配,业务由企业定义。